La técnica quirúrgica de un sistema de placas se escaneó hace años, de la copia en papel que llevaba un representante a los congresos. El PDF tiene la primera página un poco torcida y una anotación en lápiz en el margen de la página seis. Es el único lugar donde están los pasos de la cirugía y las medidas del instrumental. Una persona lo abre y lo lee sin problema. Para un asistente de IA que recorre el sitio, son veinte fotos de páginas.
Qué puede leer un asistente
ChatGPT, Gemini, los resúmenes de IA de Google y el asistente que una empresa instala en su propio sitio trabajan con texto. Leen lo que está escrito en la página como texto: títulos, párrafos, tablas armadas como tablas, el texto de los enlaces, la descripción alternativa de una imagen. De un PDF leen la capa de texto, que existe cuando el archivo se exportó desde el documento original.
Un PDF escaneado no tiene esa capa. Algunos sistemas intentan reconocer las letras de la imagen, y para un párrafo común a veces alcanza. En un documento de dispositivos médicos el reconocimiento falla justo donde importa: un código donde una «O» se lee como cero, una medida de 3,5 que pierde la coma, un superíndice de marca registrada que se pega a la palabra. Un asistente que toma ese dato mal leído da una respuesta con un producto que no existe. Y muchos rastreadores directamente no lo intentan, así que en la práctica el documento queda afuera.
Hay una prueba simple para saber de qué tipo es cada archivo: abrirlo y tratar de seleccionar una línea con el cursor. Si se marca la página entera como un bloque, es una imagen.
Los otros lugares donde el contenido desaparece
El texto dentro de imágenes. Una tabla de medidas exportada como imagen para que conserve el diseño del catálogo, una infografía con las indicaciones, el nombre del producto que solo aparece en la foto de la caja. El asistente recibe una imagen, con una descripción que muchas veces es solo el nombre del archivo.
El video sin transcripción. Cuando los pasos de una técnica están solo en la voz del cirujano que la explica, el asistente sabe que hay un video y su título, nada más.
Lo que está detrás de un formulario o de una contraseña. Un estudio clínico que se descarga después de dejar el mail, un área exclusiva para profesionales. Un rastreador no completa formularios. A veces es una decisión correcta: hay material que la empresa quiere entregar solo a quien se identifica. La consecuencia es que ese material no va a servir de fuente para ninguna respuesta, y conviene que la decisión se tome sabiéndolo.
La relación que nadie escribió. Aunque el texto exista, si el único vínculo entre un producto y su técnica quirúrgica es un botón que dice «Descargar» y lleva a un archivo llamado TQ_v3_final.pdf, el asistente no tiene cómo saber a qué producto corresponde ese documento.
Qué darle a cambio
La ficha de producto con los datos escritos como texto: nombre comercial, códigos, medidas, materiales e indicaciones, cada uno en su campo. El documento enlazado con su título, su número y el producto al que pertenece escritos junto al botón de descarga.
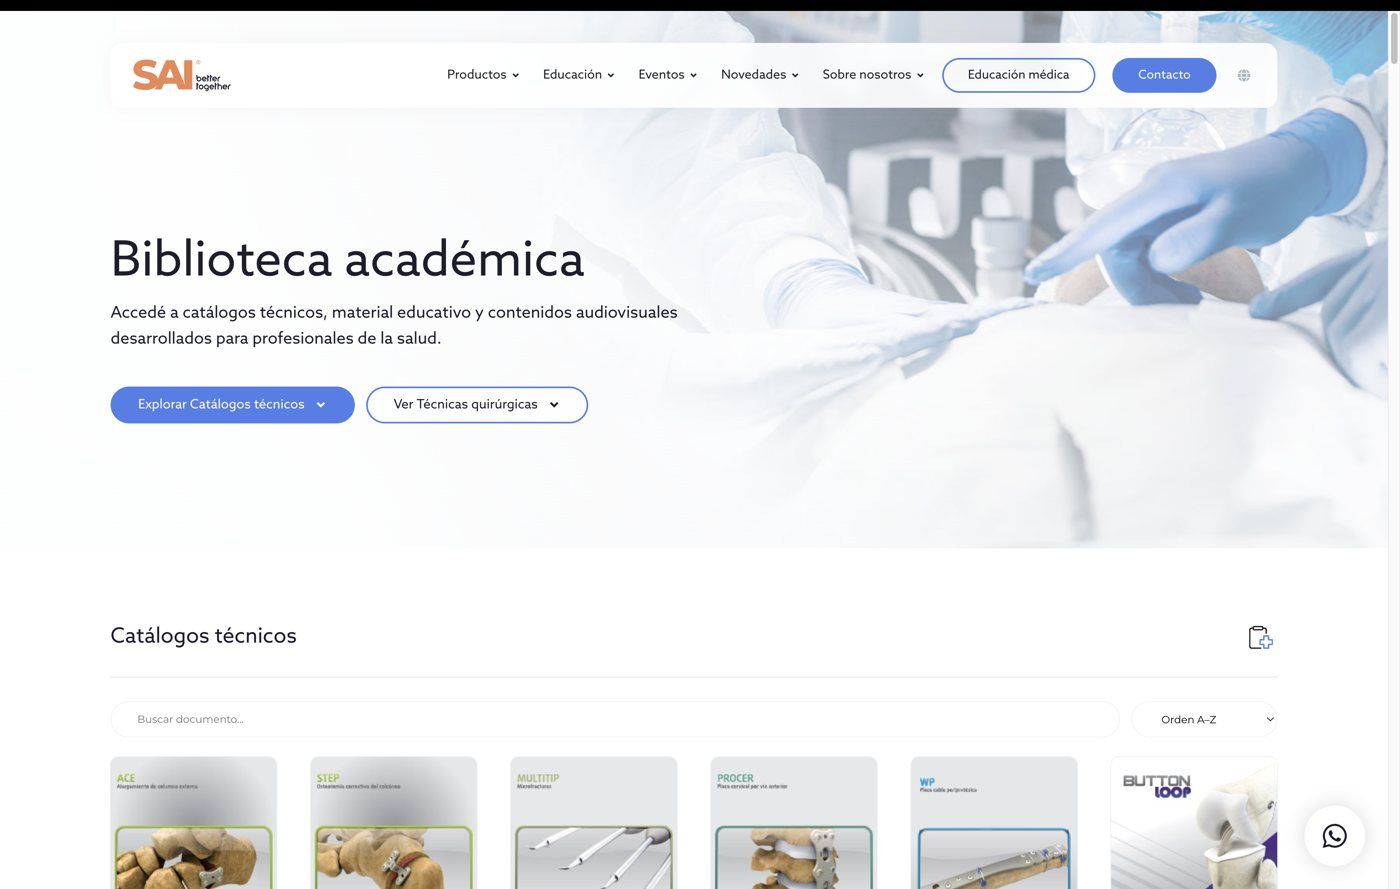
En la ficha de un sistema de SAI, fabricante y distribuidor ortopédico argentino, el nombre del sistema, la descripción de una línea y los accesos a «Descargar catálogo» y «Códigos de producto» son texto de la página, y el catálogo enlazado aparece con su número de documento y su título escritos al lado de la portada. Un asistente que llega a esa página encuentra el producto y su documento en el mismo lugar.
Para los PDFs, la versión exportada desde el archivo original, no la escaneada. Si el original se perdió, el documento se vuelve a componer. Cuando es un instructivo de uso aprobado, la versión en texto la coteja la empresa contra el original, y el PDF aprobado sigue siendo la referencia. Para las imágenes con información, una descripción que diga lo que muestran. Para los videos de técnica, la transcripción publicada en la misma página.
El asistente propio de la empresa necesita lo mismo. Se diseña para responder con lo que se le cargó, y un instructivo escaneado cargado como fuente le da poco para responder o, peor, un dato mal leído para repetir.
Por dónde empezar
Un inventario de lo que el sitio publica, marcado en tres columnas: si el archivo tiene texto o es imagen, si hay información importante dentro de imágenes o videos, y si algo está detrás de un formulario. El orden de trabajo lo dan los documentos que la gente más descarga y las páginas por las que más se entra: es el material que ya se está usando y que, hoy, solo una persona puede leer.
Nada de esto asegura que un asistente mencione a la empresa. Cuál cita y cuándo lo deciden sistemas que cambian y que nadie controla desde afuera. El inventario se ocupa de un paso anterior: que la información de la empresa esté escrita en un formato que un asistente pueda leer.
Servicios de los que habla esta nota